📋→⚡
规范到执行环
Specification-to-Execution Loop
将自然语言目标自动转化为可运行的 ML/智能体管线。
AutoML-GPTAutoML-Agent
💡 The gap between "what you want" and "what runs" is the first evolution bottleneck.
这是一个 dated survey snapshot,不是完成版系统综述:它把 196 篇论文展示集、686 个 classified GitHub repos 和 97 个公开讨论信号组织成五类工作回路,并标出哪些 claim 仍需回到论文、项目或 benchmark 源复核。
[INFERRED] 五类工作回路是本 Survey 的当前整理框架,不是领域已定标准。
[KNOWN] 计数来自 site data 与 master index 生成口径;逐 claim 的 source matrix 仍在补齐。案例里的 benchmark 数字只按论文或项目原始报告转述,本站不声称已经独立复现。
这些图不是装饰图,而是把论文章节、网站页面和数据资产连起来的读者证据地图:先看图,读者才知道每章为什么存在,以及哪些部分仍是快照。
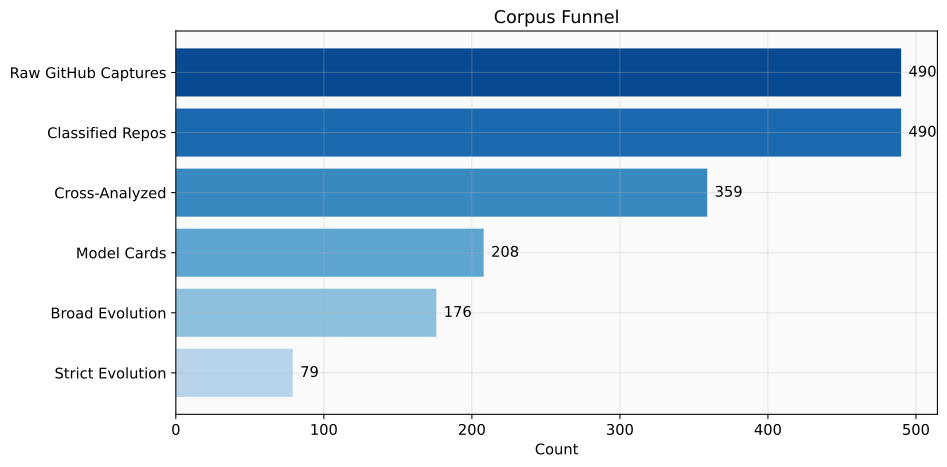


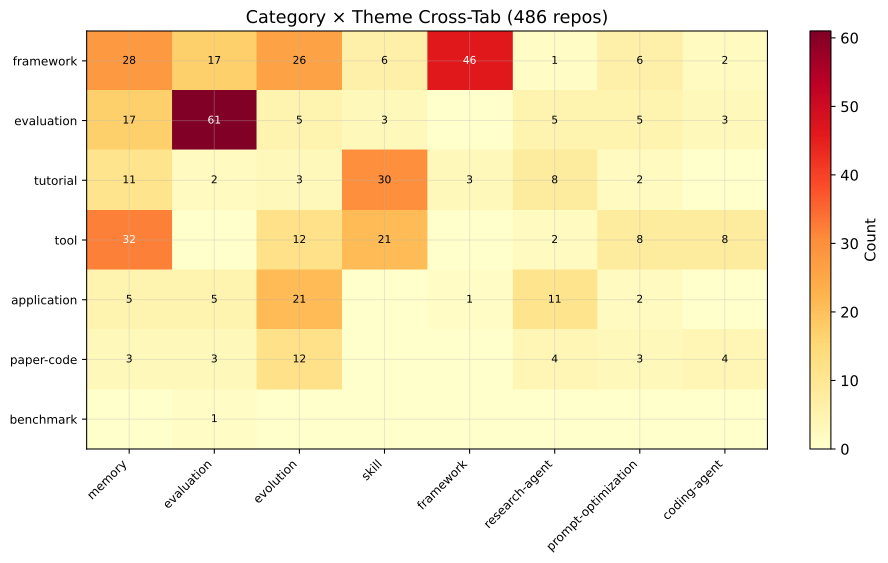


当前整理口径:把散乱的“自改进”文献先分成五个可组合的工作回路,方便读者追问 mutable object、feedback、verifier、retention 和 rollback;它仍需要更多 source-level 交叉验证。
Specification-to-Execution Loop
将自然语言目标自动转化为可运行的 ML/智能体管线。
💡 The gap between "what you want" and "what runs" is the first evolution bottleneck.
Search Loop
探索架构、提示词、代码、智能体和超参数空间,寻找更优设计。
💡 LLMs as search operators unlock combinatorial spaces that gradient methods cannot reach.
Evaluator Loop
测试、基准验证候选改动是否为真正的改进。
💡 Without a reliable evaluator, self-improvement is indistinguishable from random walk.
Reflection Loop
将失败转化为记忆,从反馈信号生成修正候选。
💡 The reflection loop is where experience becomes reusable knowledge.
Population Loop
维护多个候选方案,跨代选择、变异和重组。
💡 Population-level evolution discovers solutions no single trajectory can reach.
代码级自修改 + 开放式归档继承。
元智能体搜索 Python 编码的 Agent 架构。
LLM + 进化算法在可自动评估任务中报告新算法发现。
技能库积累创造复合回报。
失败 → 文本反思 → 记忆 → 避免重复错误。
模型自己生成奖励 → 自己训练 → 自我强化循环。
Mom Test 方法论用于阅读公开讨论:Reddit 47 条、Hacker News 36 条、X/Twitter 14 条。这里统计的是公开语义信号,不是受控访谈样本。
38 个痛点
The "80% curse": agent task chains fail multiplicatively, making 95%+ reliability extremely hard.
Survey 证据:97 public discussion signals across Reddit, HN, and X/Twitter point to reliability ceilings as a recurring blocker.
22 个痛点
Loop drift, plateau, and human dependency: self-improvement loops often stall or degrade.
Survey 证据:Paper analysis shows most methods report single-iteration gains; multi-iteration stability is under-studied.
15 个痛点
Abstraction overuse, deprecation risk, and false "team" metaphors plague agent frameworks.
Survey 证据:GitHub project analysis suggests framework readiness remains uneven; the framework score is heuristic, not benchmark-rerun evidence.
12 个痛点
Benchmark contamination + Goodhart's law = "benchmaxxing" that doesn't transfer to production.
Survey 证据:Cross-source validation reveals gap between benchmark claims and real-world performance.
10 个痛点
Permission escalation, prompt injection, and misevolution risks are under-addressed in research.
Survey 证据:Only 4/196 papers (2%) focus on evaluation/safety/governance as primary contribution.

自进化应当被评估为一个受控的系统过程:每一个声称的改进都必须说明——改变了什么?什么反馈支持这次改变?什么评估器批准了它?成本多少?引入了什么风险?如何审计和回滚?